|
TwojePC.pl © 2001 - 2026
|
 |
Czwartek 12 listopada 2026 |
 |
| |
|
Rzut okiem na najnowszą mikroarchitekturę AMD Zen 6/6C
Autor: Wedelek | 06:16 |
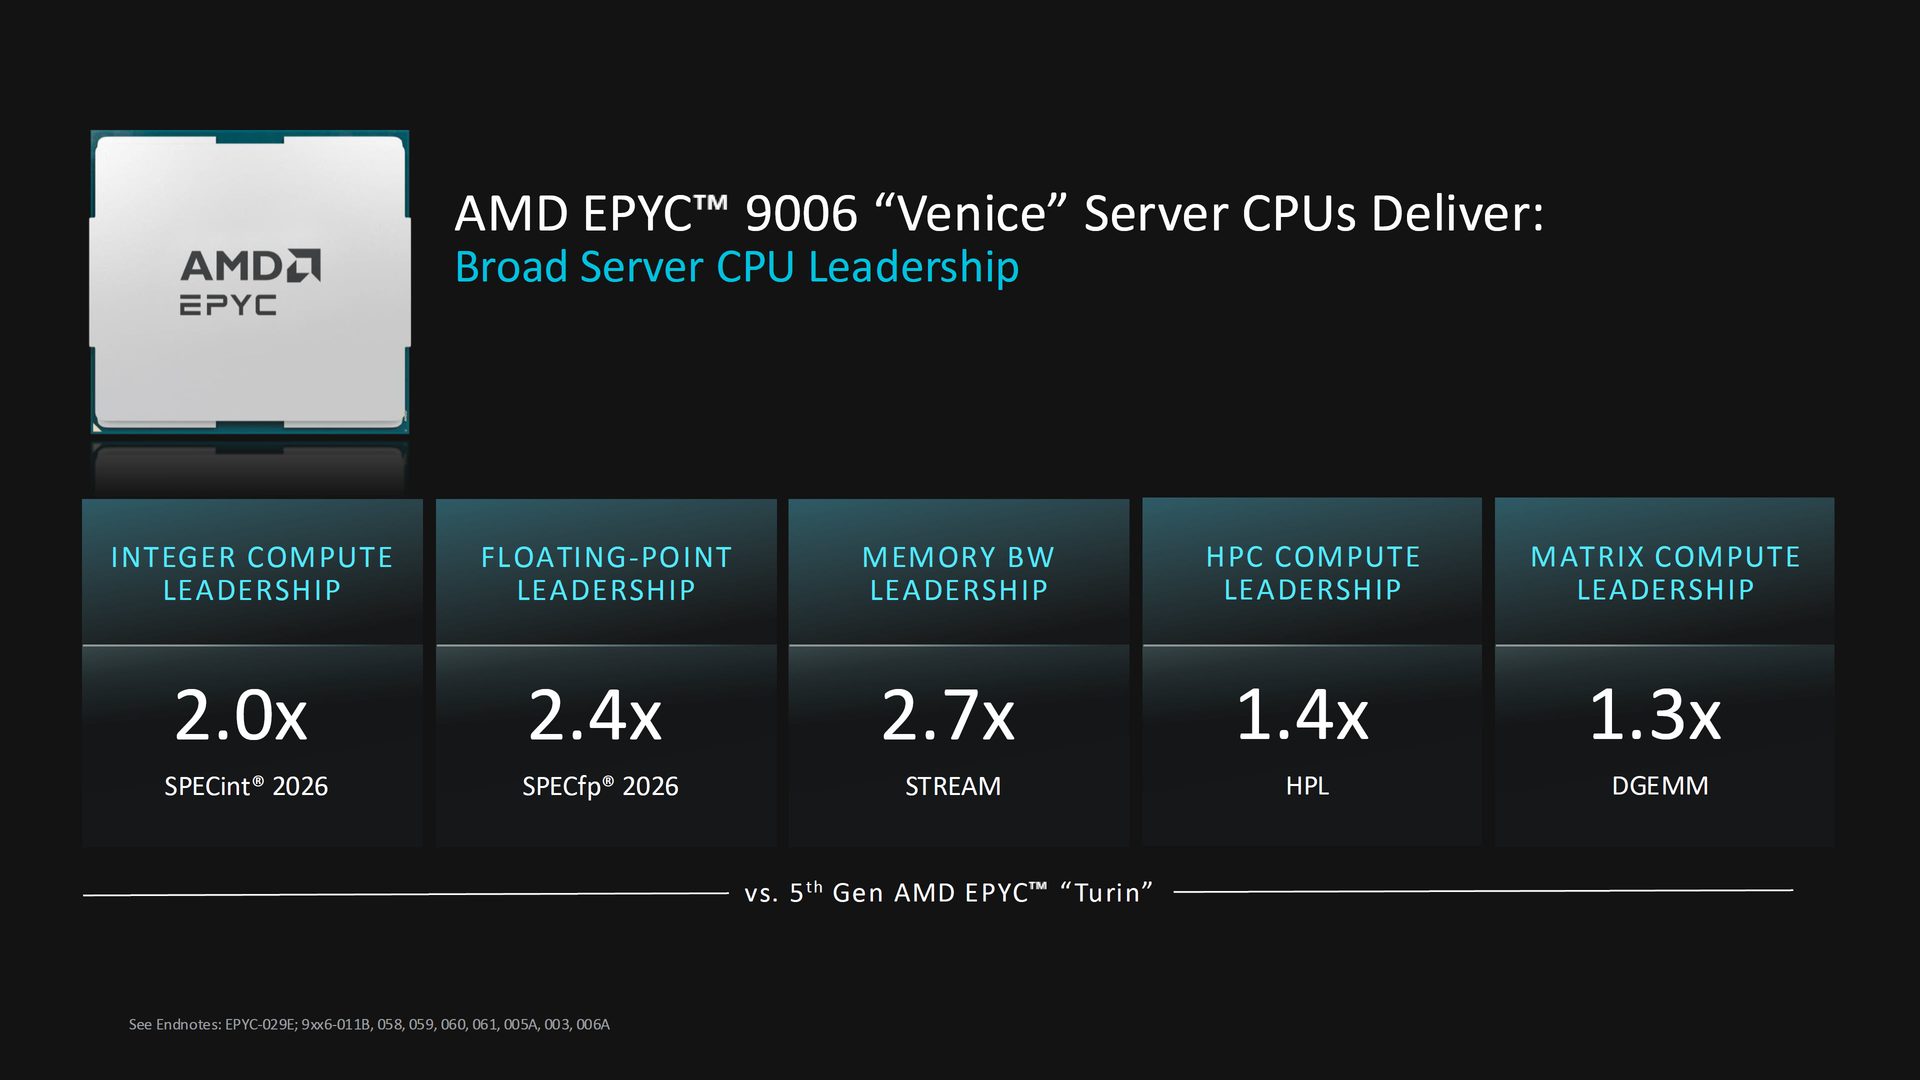
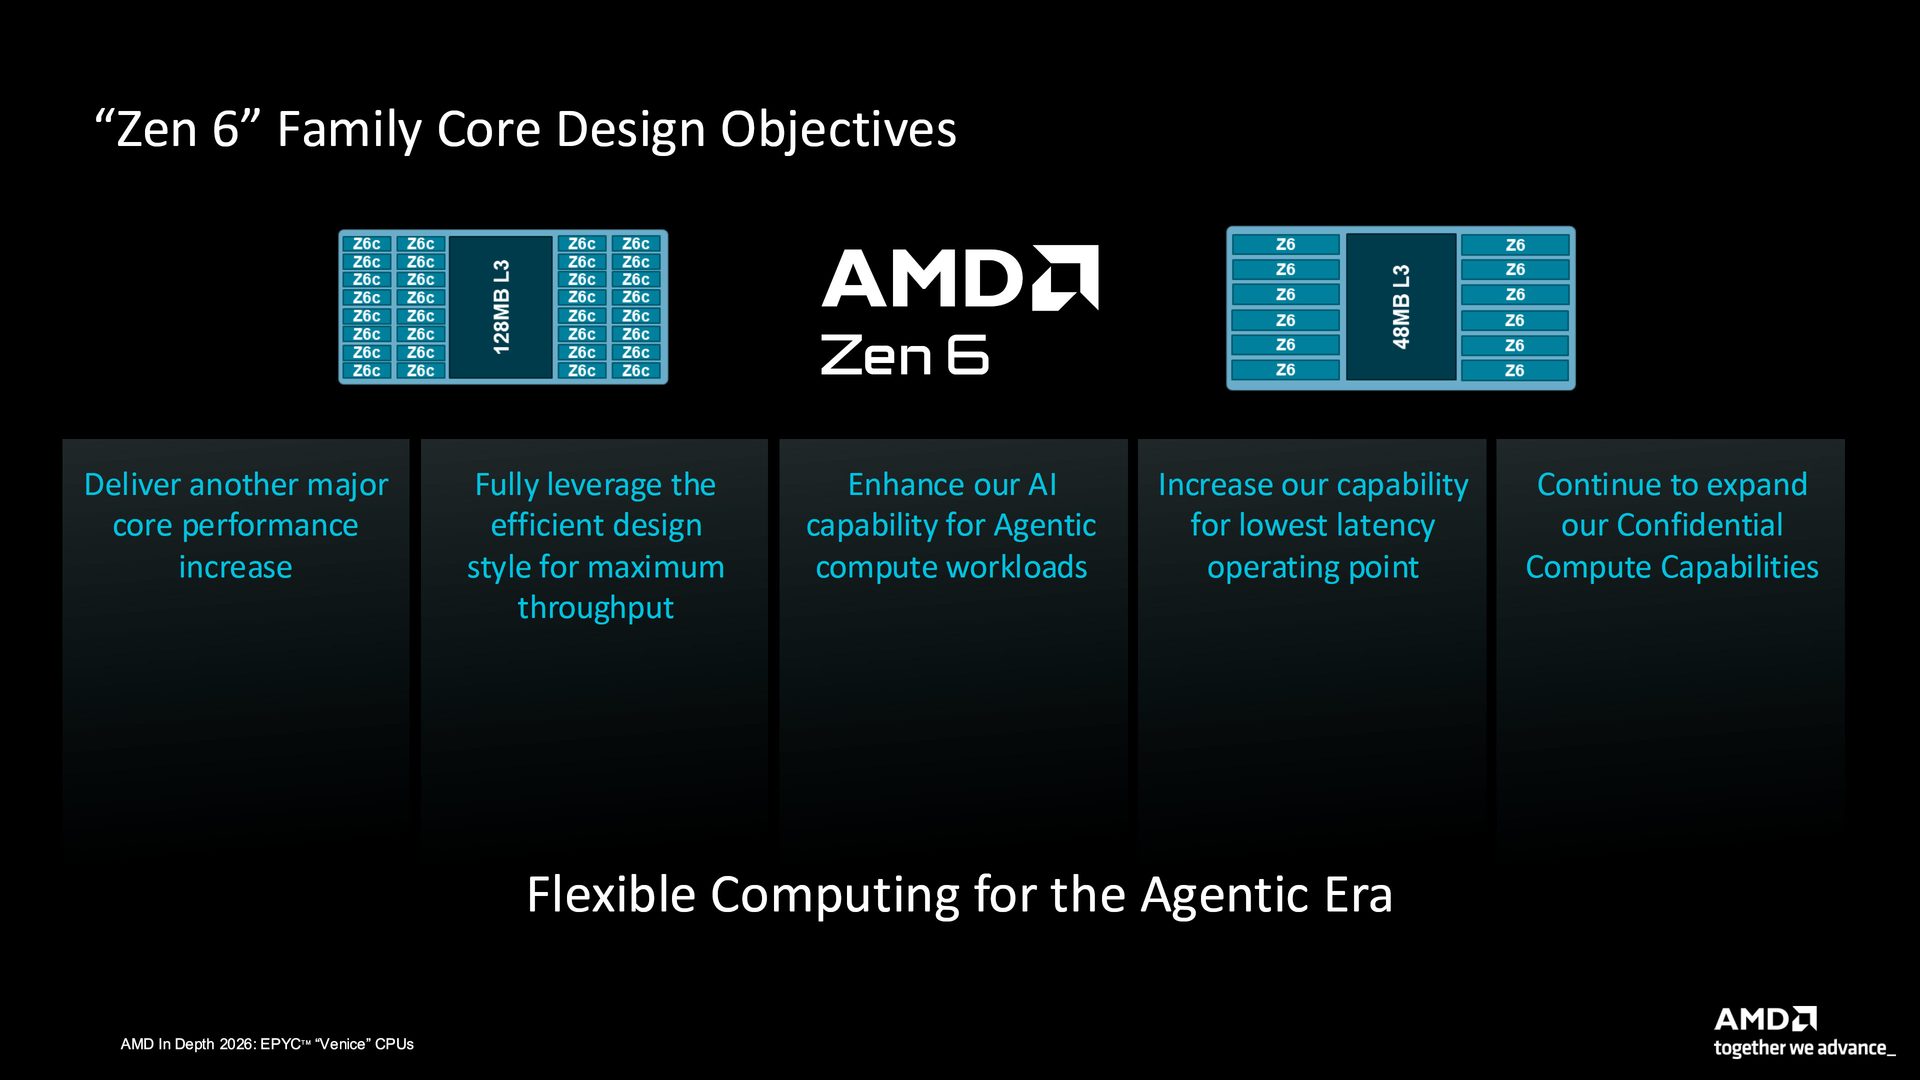
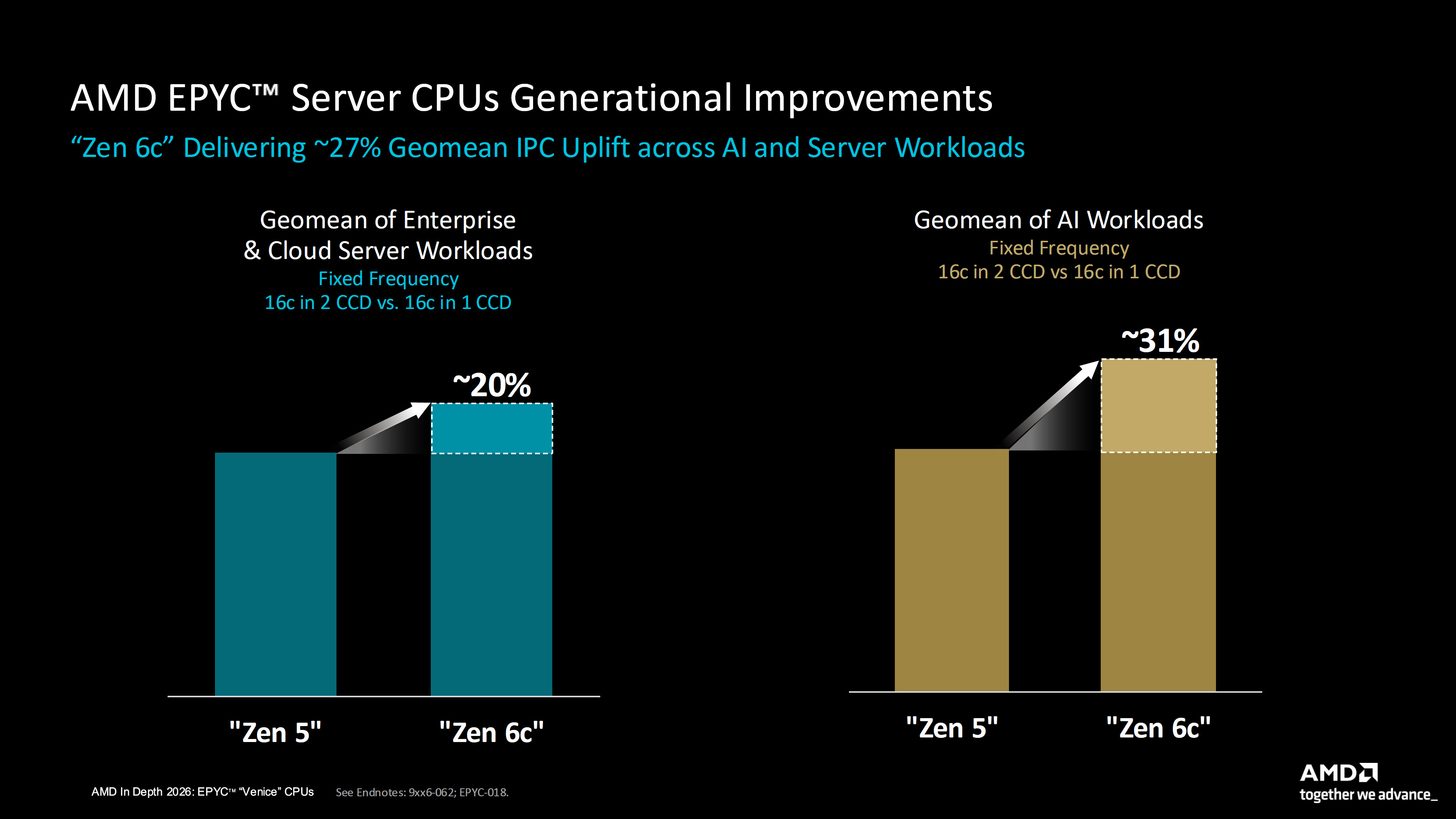
(2) |  AMD pokazało nam nowe procesory oparte na bazie architektury Zen 6, a ta przynosi ze sobą olbrzymi, bo aż 27% wzrost IPC względem wersji 5 (dotyczy Zen 6C). Procesory AMD EPYC doczekały się dotychczas sześciu generacji z czego ta najnowsza, o kryptonimie Venice, została zaprojektowana z myślą o erze Agentic AI i w jej ramach AMD oferuje jednostki wyposażone w maksymalnie 256 rdzeni, z przepustowością do 12,8 GT/s MRDIMM. Wzorem poprzedników znów mamy podział na dwa rodzaje rdzeni: pełne Zen 6 i nieco mniejsze i bardziej efektywne energetycznie 6C.
Już na wstępie trzeba zaznaczyć, że AMD wprowadziło istotne zmiany w uArch Zen 6, co przełożyło się na wyższą wydajność, lepsze wykorzystanie dostępnej mocy, niższe opóźnienia oraz rozszerzone funkcje bezpieczeństwa. Ale po kolei.
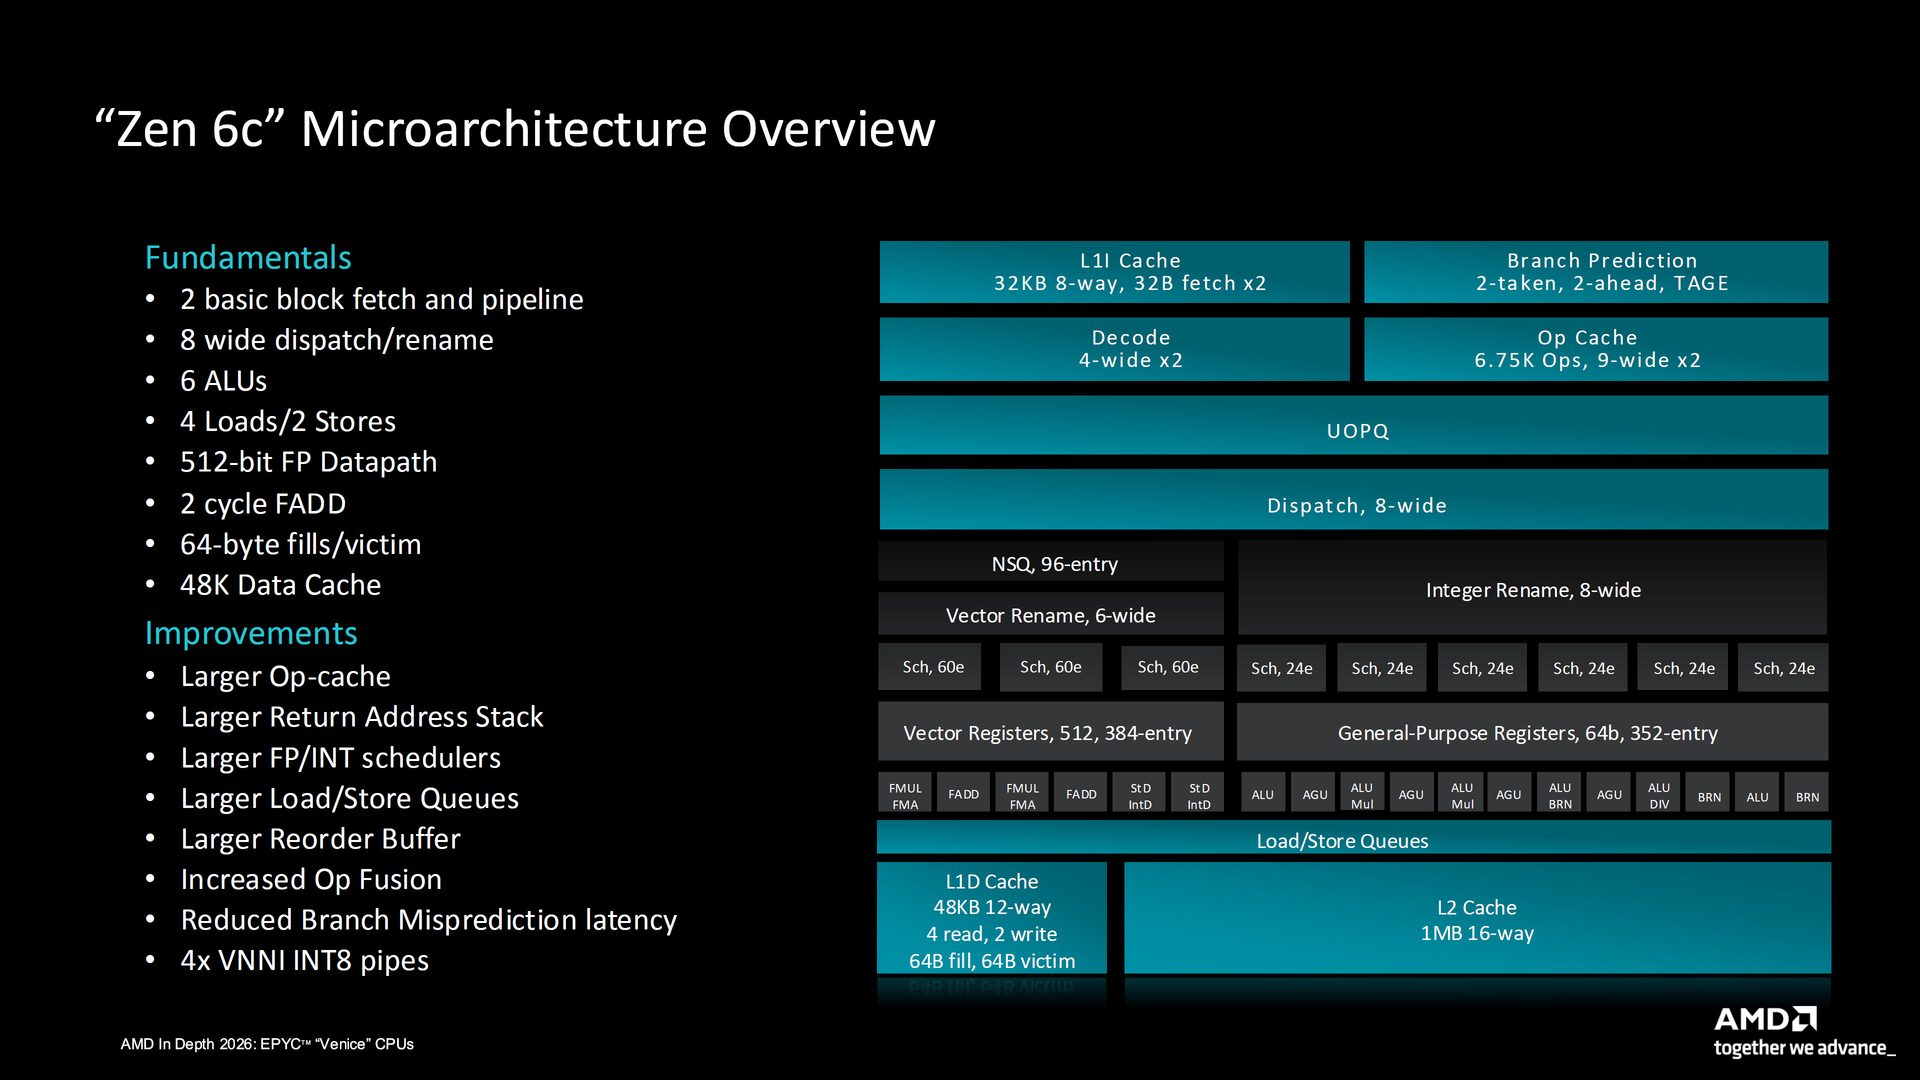
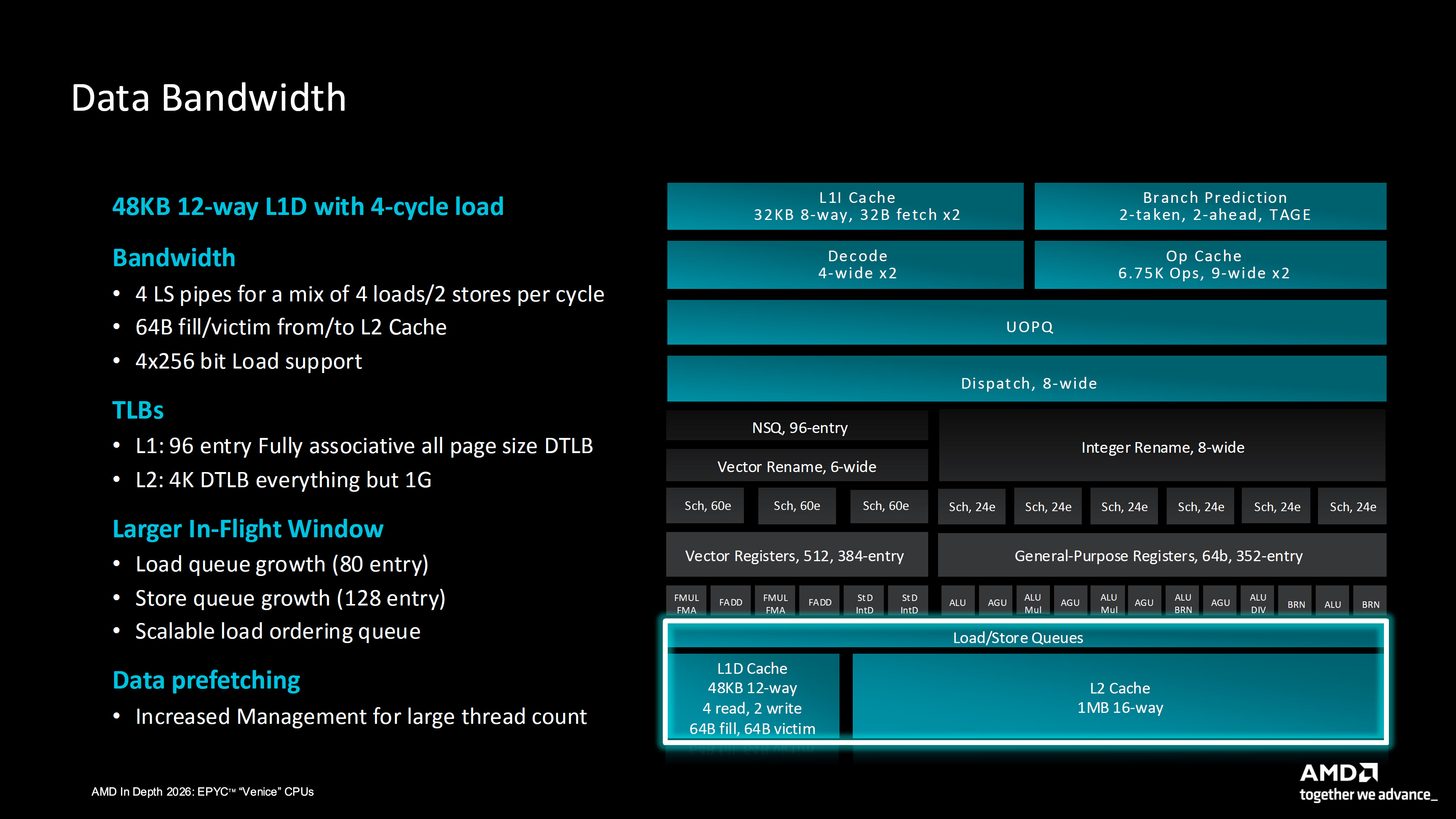
Zacznijmy od tego, że Zen 6 i Zen 6C mają wspólny podstawowy układ rdzenia, oparty na dwóch blokach fetch i pipeline. W sumie każdy rdzeń może w jednym cyklu przydzielić do wykonania i przemianować rejestry dla 8 operacji (8-drożny dispatch/rename), a do obliczeń na liczbach całkowitych ma 6 jednostek ALU. Jego podsystem pamięci obsługuje do 4 odczytów i 2 zapisów na cykl, a dane między pamięciami podręcznymi przenoszone są w porcjach po 64 B (fills/victim). Z kolei do obliczeń na liczbach zmiennoprzecinkowych wykorzystywana jest 512-bitowa ścieżka danych, na której dodawanie FADD trwa 2 cykle. Całość uzupełnia pamięć podręczna dla danych poziomu pierwszego (L1), która ma 48 KB.
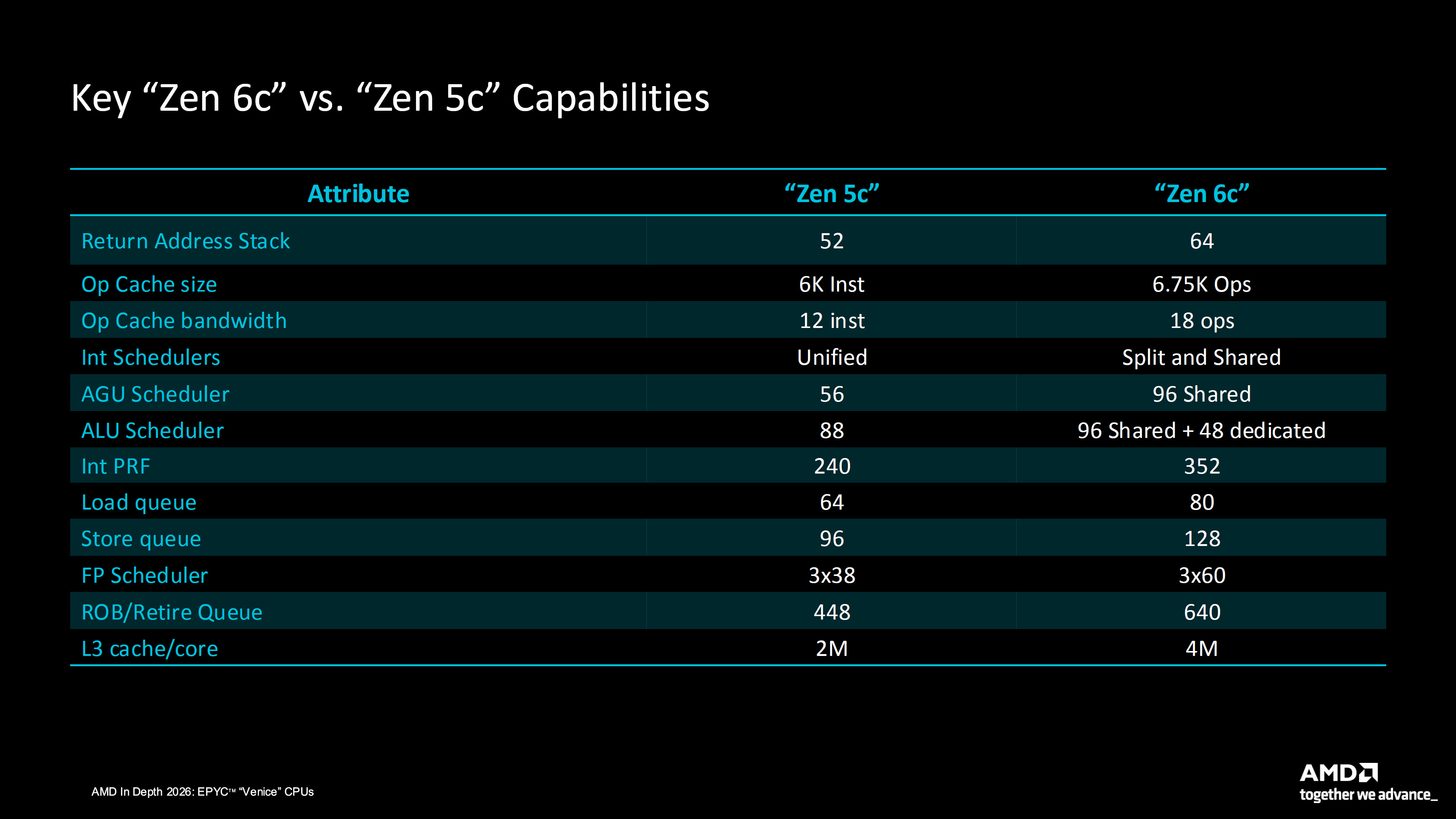
Poziom wyżej pojawiły się powiększone Op-cache, Return Address Stack, większe schedulery FP/INT i kolejki Load/Store i oraz bardziej okazały Reorder Buffer. Do tego dochodzą rozszerzony OP Fusion, krótsze opóźnienie błędnej predykcji skoku oraz 4 potoki VNNI INT8.
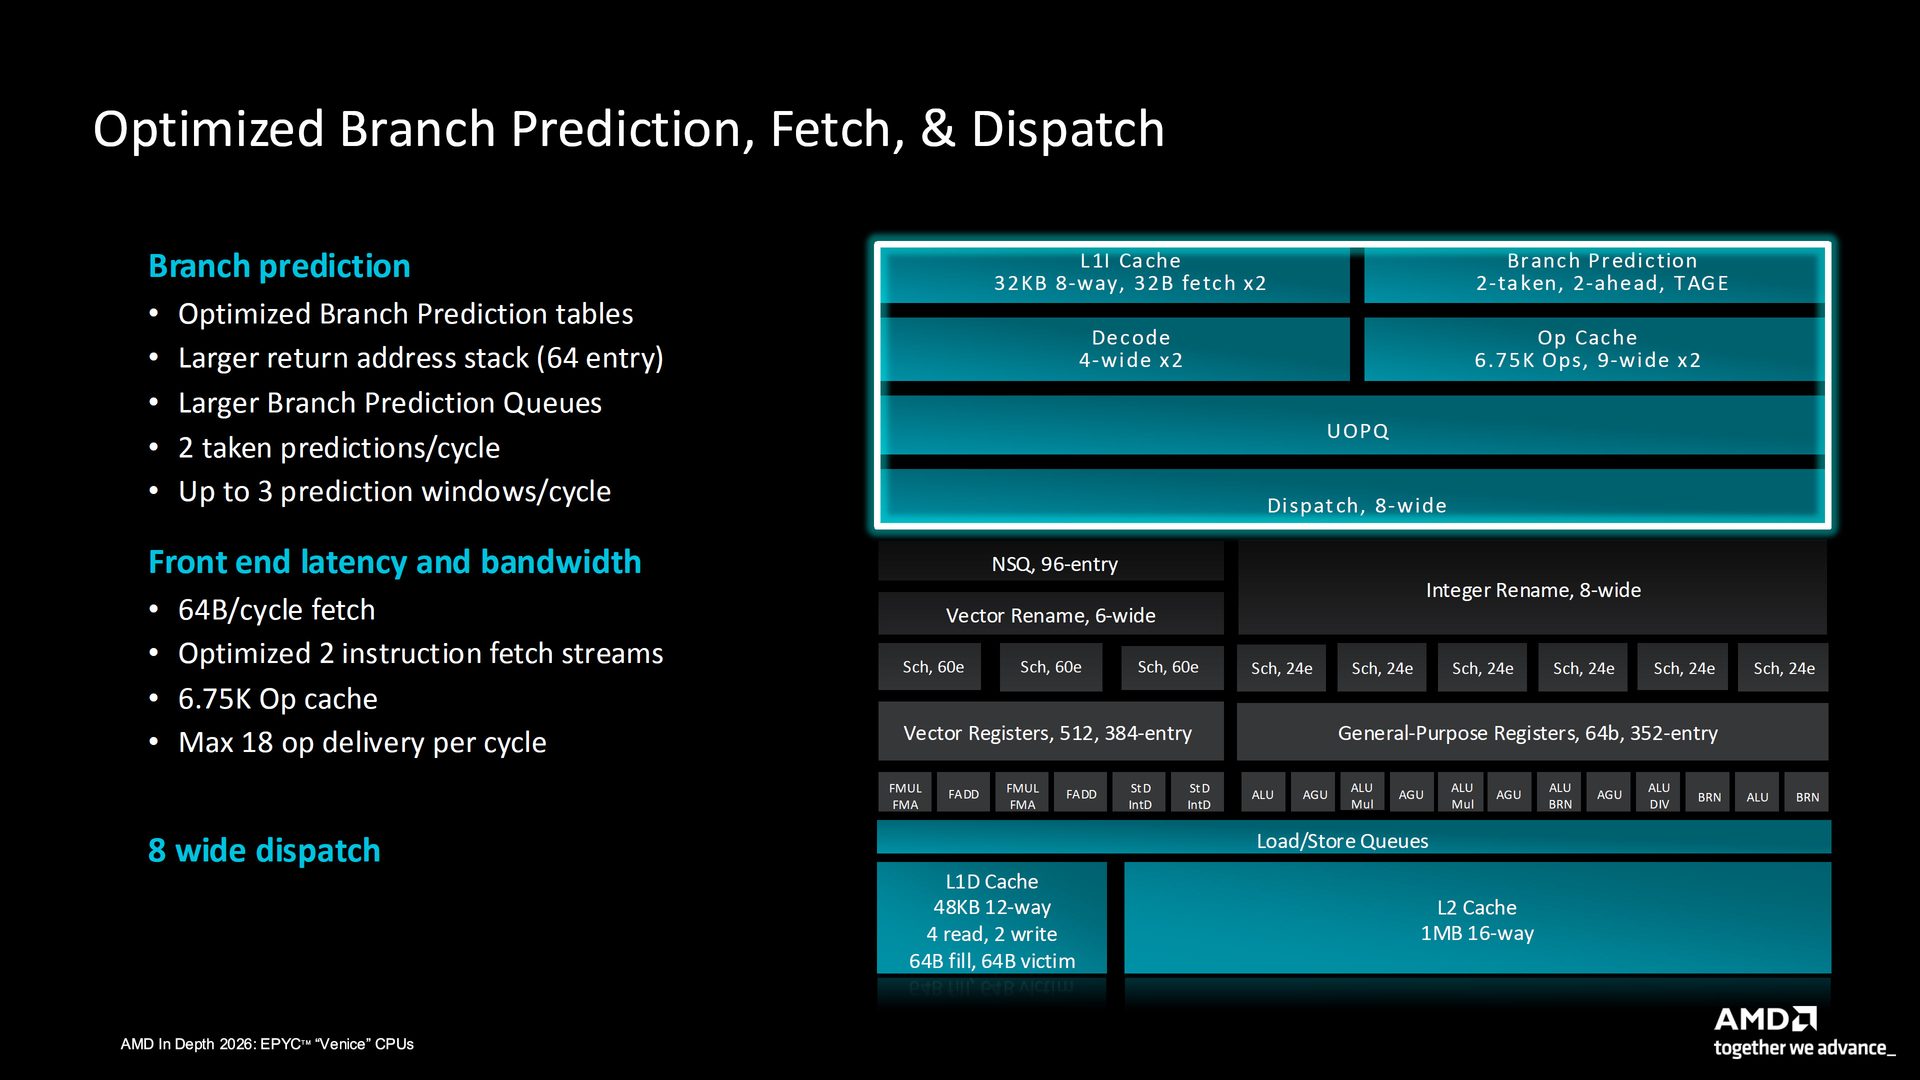
Aby procesor działał sprawniej predykcja skoków dostała zoptymalizowane tablice, większy return address stack mieszczący teraz 64 wpisy i większe kolejki predykcji skoków. Pojawiła się też obsługa większej ilości przewidywania skoków wykonanych (taken) na cykl (teraz są to 2 skoki) oraz trzy okna predykcji na cykl. Na Front-endzie procesor pobiera teraz do 64B danych na cykl i dysponuje op cache o rozmiarze 6,75K oraz 8-drożną jednostkę dispatch, obsługując maksymalnie 18 operacji na cykl. Wszystkie te informacje mieszczą się w podręcznej pamięci instrukcji L1I, która ma 32 KB.
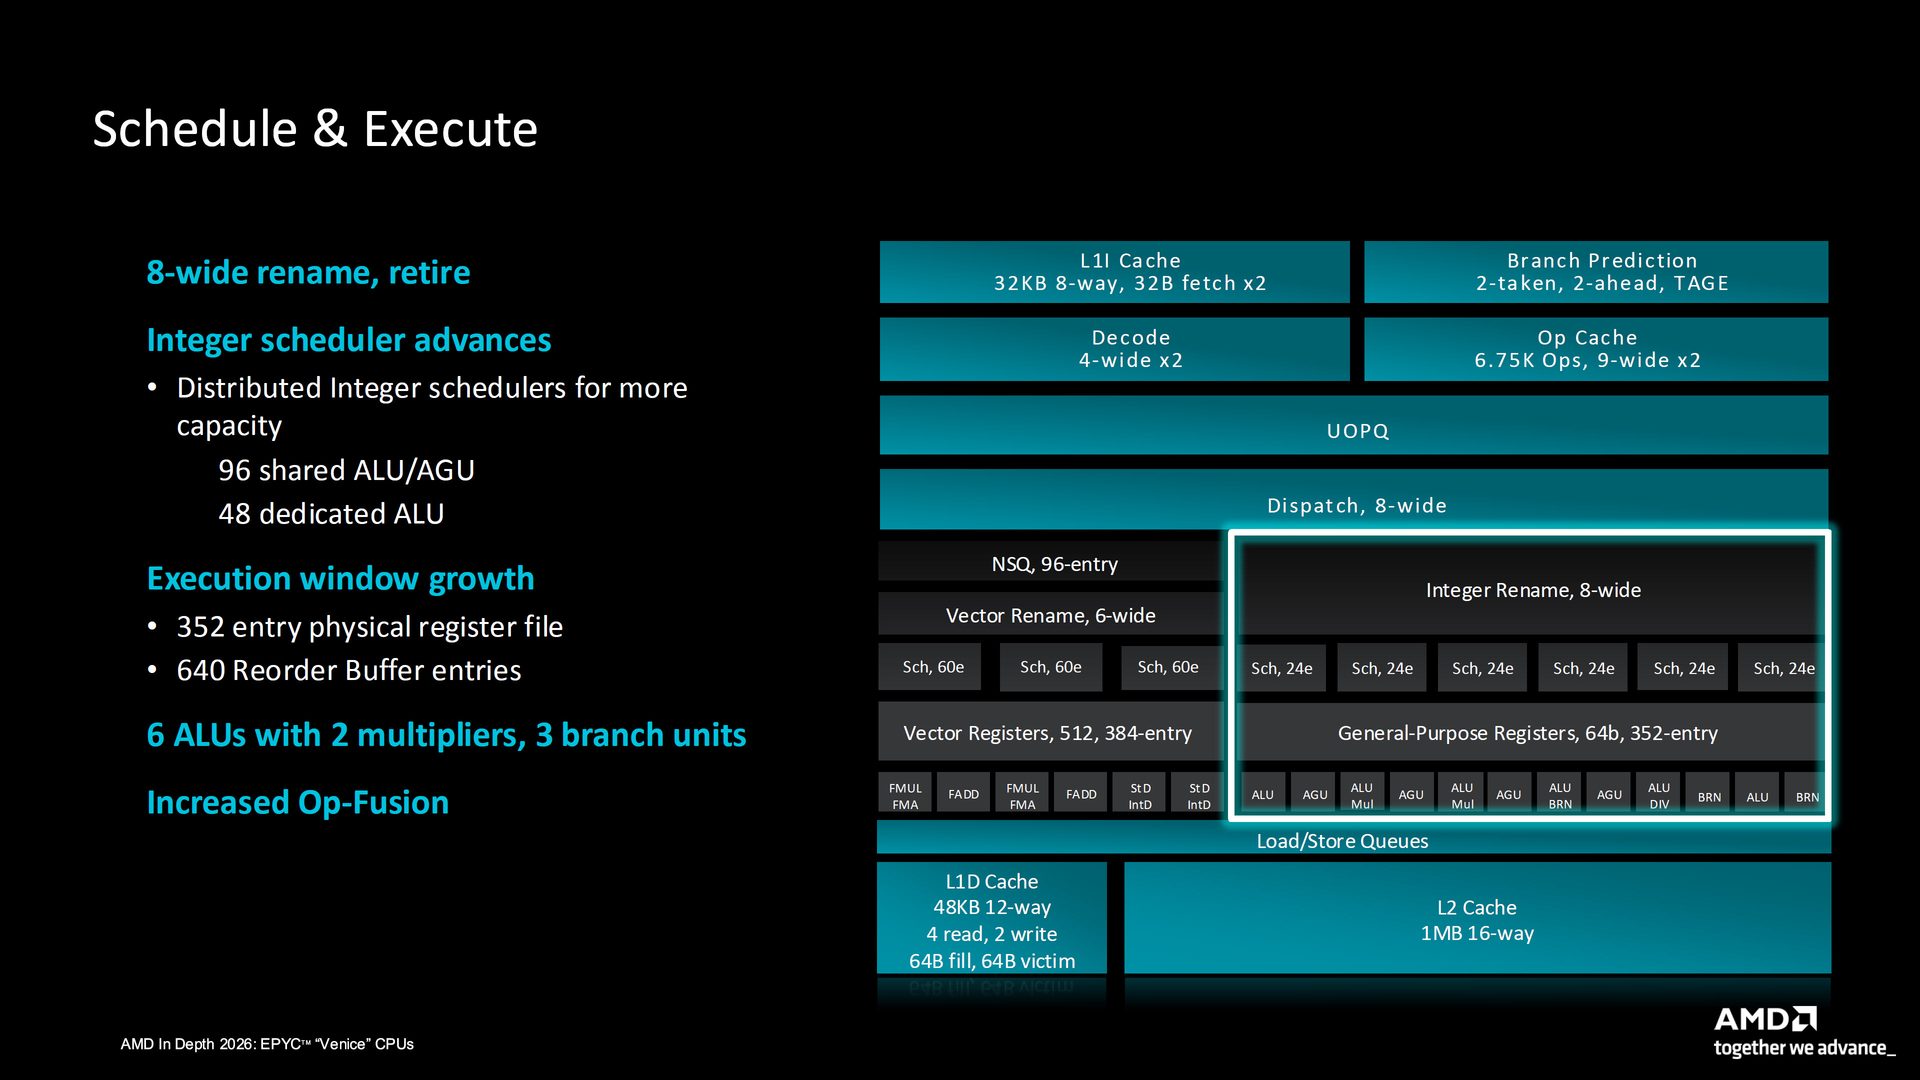
Zen 6 dostał też 8-drożne bloki rename i retire oraz rozproszonych planistów (schedulery) pracujących liczbach stałoprzecinkowych. Obejmują one 96 współdzielonych jednostek ALU/AGU i 48 dedykowanych ALU. Okno wykonania również urosło: plik rejestrów fizycznych ma 352 wpisy, a reorder buffer 640. Łącznie rdzeń ma 6 ALU, w tym 2 jednostki mnożące i 3 jednostki skoków, a także zwiększony OP-Fusion.
Po stronie ścieżki danych Zen 6 ma 48 KB pamięci L1D (12-drożna), a przepustowość zwiększają 4 potoki LS, które dają mieszankę 4 odczytów i 2 zapisów na cykl. Do tego dochodzą 64 B bloki fill/victim. Większe jest też okno In-Flight: kolejka load rośnie do 80 wpisów, kolejka store do 128, a do tego jest skalowalna kolejka load ordering. Każdy rdzeń ma ponadto 1 MB pamięci L2.
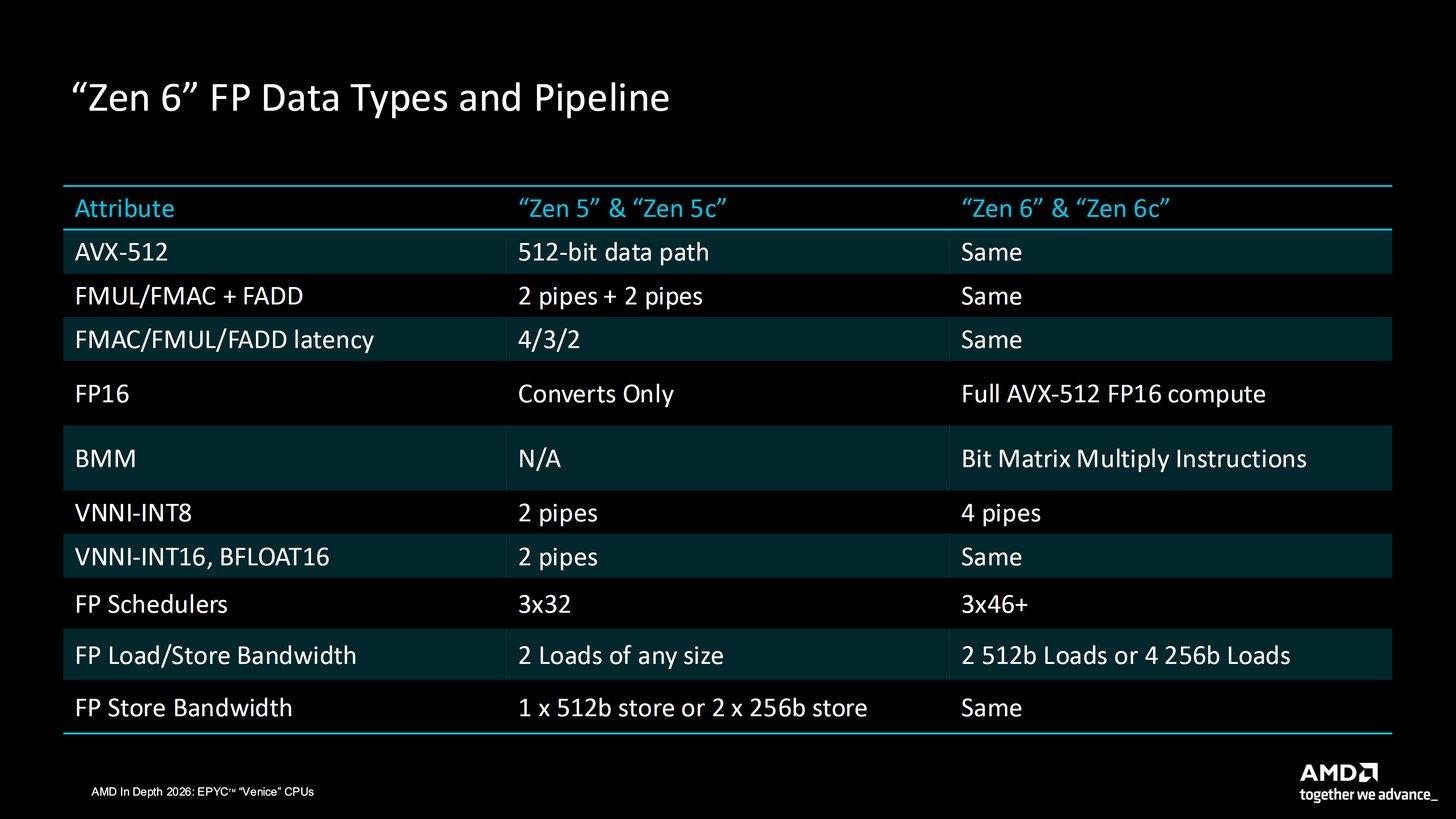
W typach danych i potoku Zen 6 i Zen 6C mają wspólne: AVX-512, FMUL/FMAC+FADD, opóźnienia FMAC/FMUL/FADD, VNNI-INT16, BFLOAT16 oraz przepustowość zapisu FP (FP Store Bandwidth).
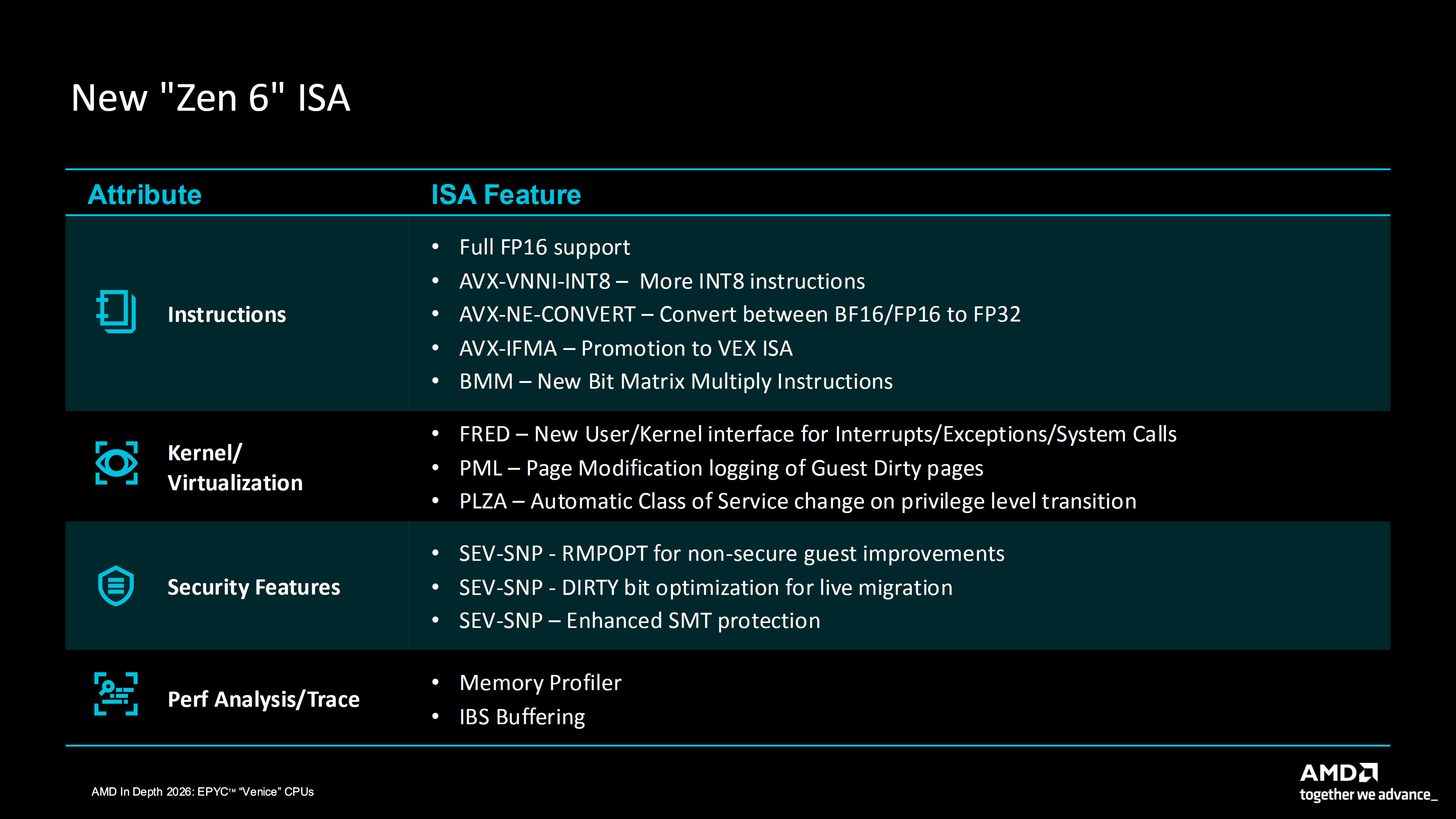
Zmienił się natomiast typ danych FP16. Obsługuje on teraz pełne obliczenia AVX-512 FP16. Doszły też instrukcje Bit Matrix Multiply i 4 potoki VNNI-INT8 (wcześniej 2). Schedulery FP to 3× 46+ (wcześniej 3×32), a w przypadku AVX rdzeń obsługuje albo 2 odczyty 512-bitowe, albo 4 odczyty 256-bitowe na cykl. Łączna przepustowość wektorowa wynosi w obu przypadkach 1024 bity (128 B) na cykl.
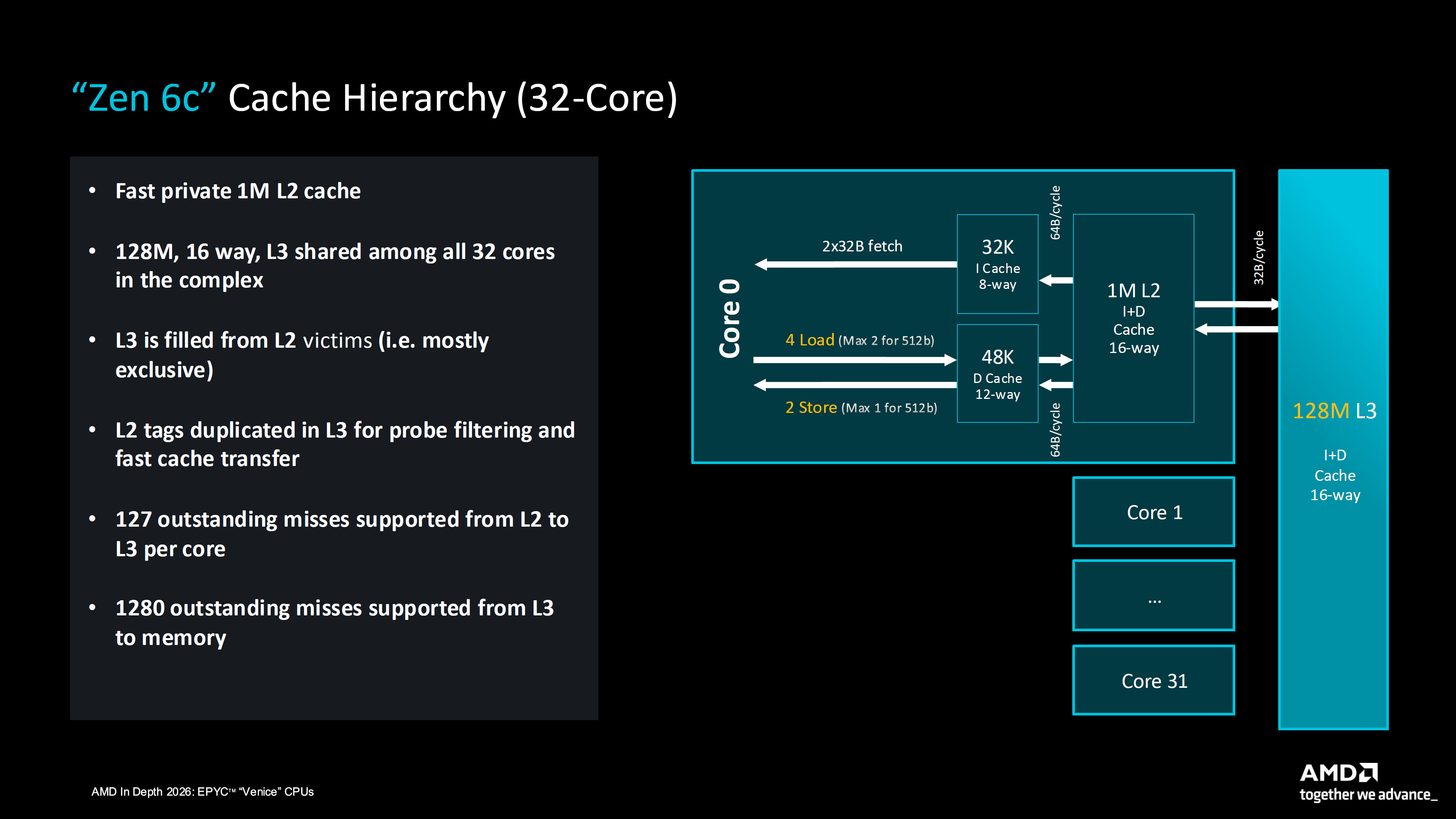
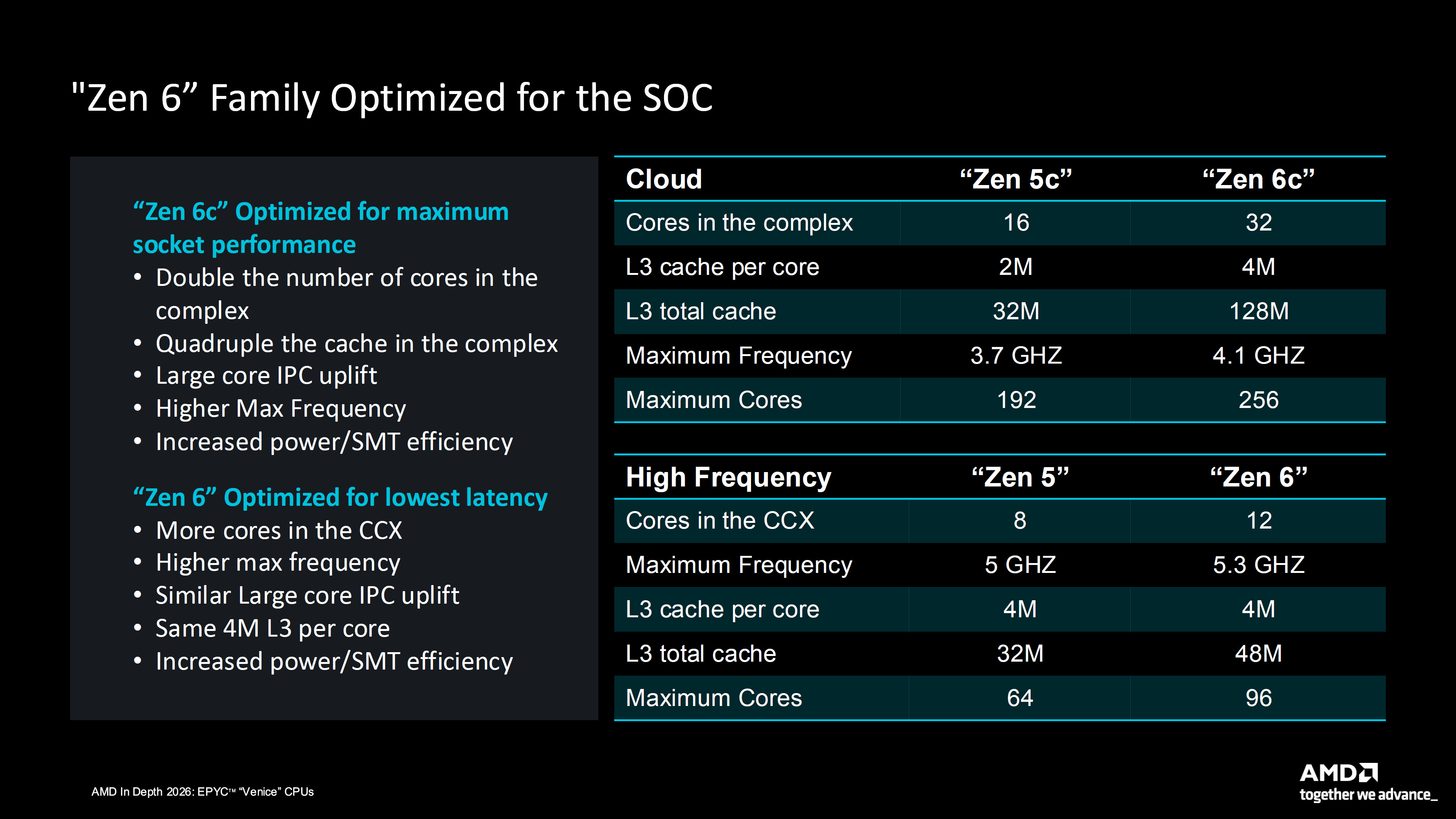
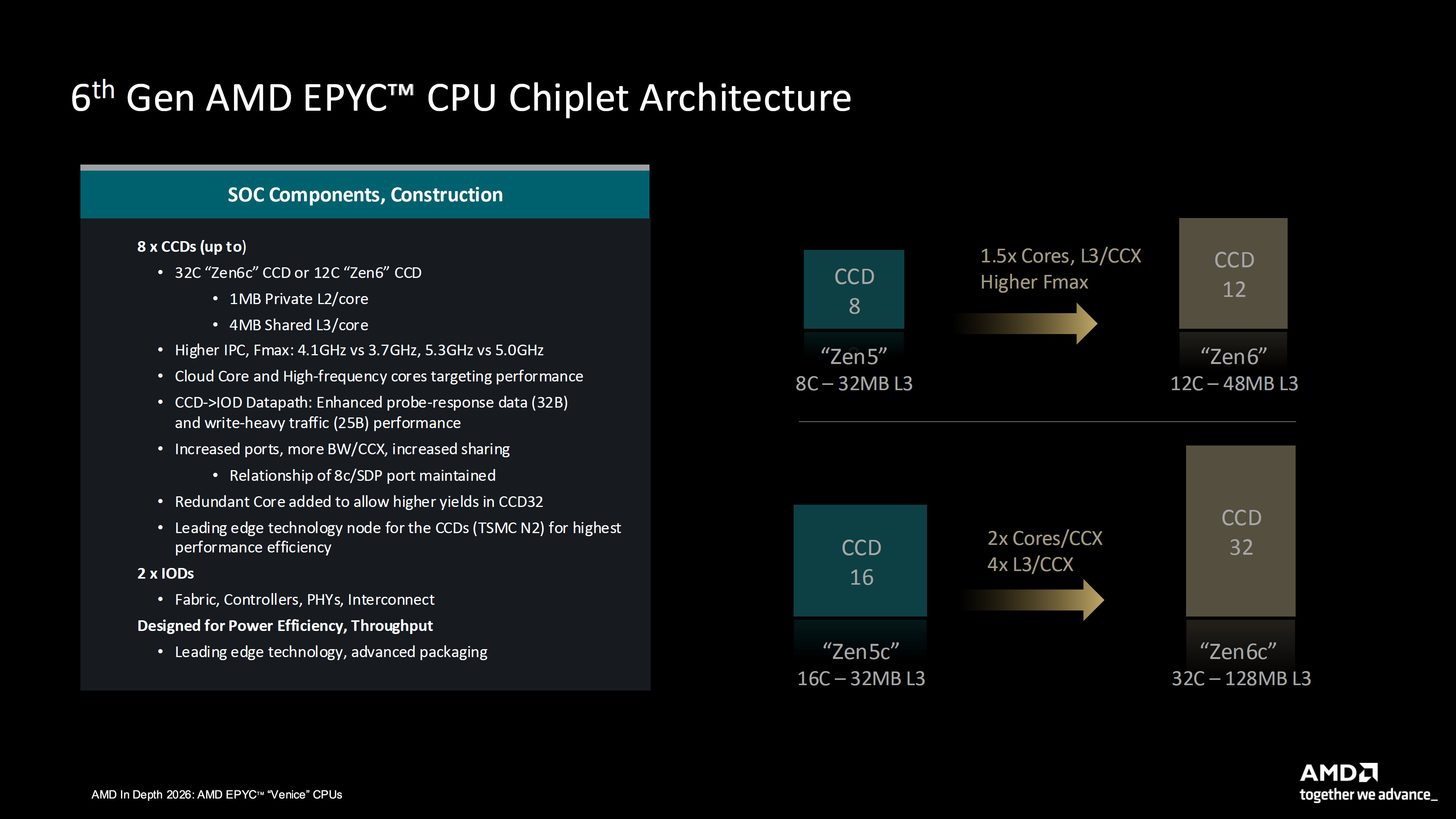
Pojedynczy CCX Zen 6 może mieć do 12 rdzeni i 48 MB pamięci L3, podczas gdy CCX Zen 6C skaluje się do 32 rdzeni i 128 MB L3.
W Zen 6C każdy rdzeń ma własną, pamięć L2 o rozmiarze 1 MB oraz dostęp do współdzielonej pamięci L3 o pojemności do 128 MB, którą współdzielą maksymalnie 32 rdzenie. Oczywiście ilość rdzeni może i jest zwiększana poprzez doklejanie kolejnych klastrów. Aktualnie do 256 rdzeni.
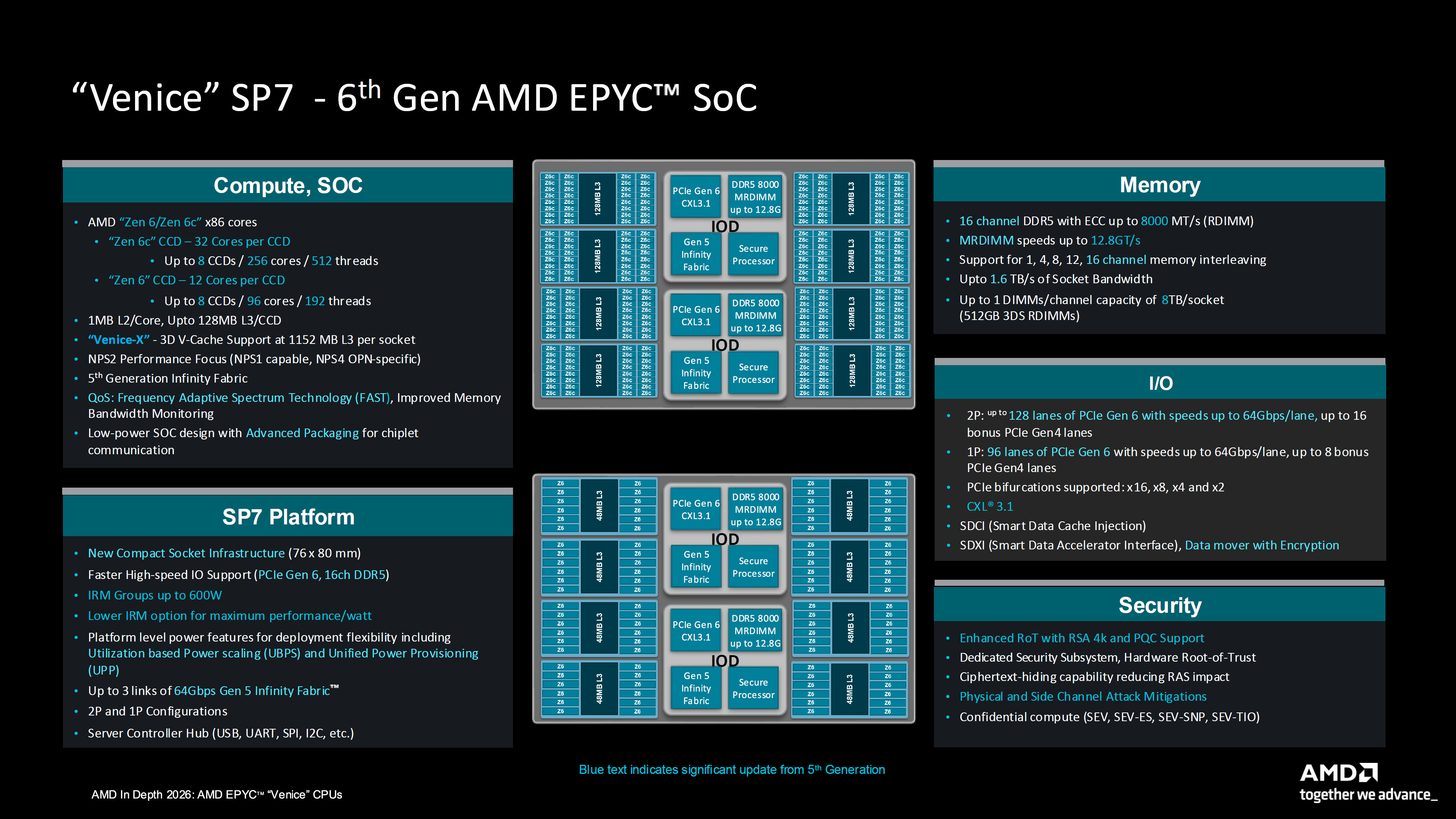
W Venice rdzenie Zen 6 i 6C są wytwarzane w litografii TSMC N2P (2 nm), a każdy rdzeń ma łącznie 1 MB pamięci L2 co daje 96 MB L2 dla rdzeni Zen 6 i 256 MB dla Zen 6C. Każdy klaster dysponuje bardzo szybkim interfejsem Infinity Fabric 5 łączącym go z pozostałymi elementami APU.
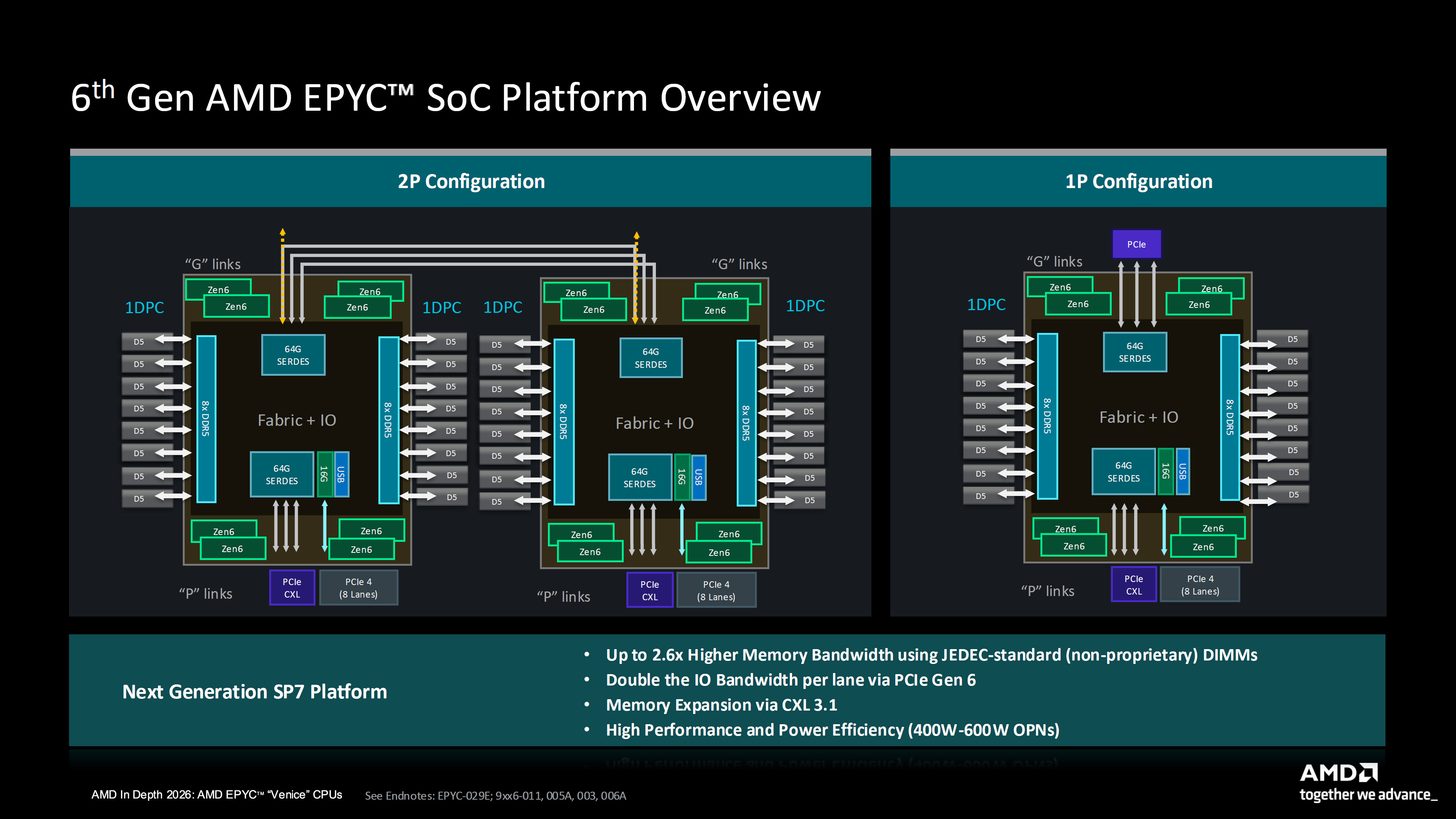
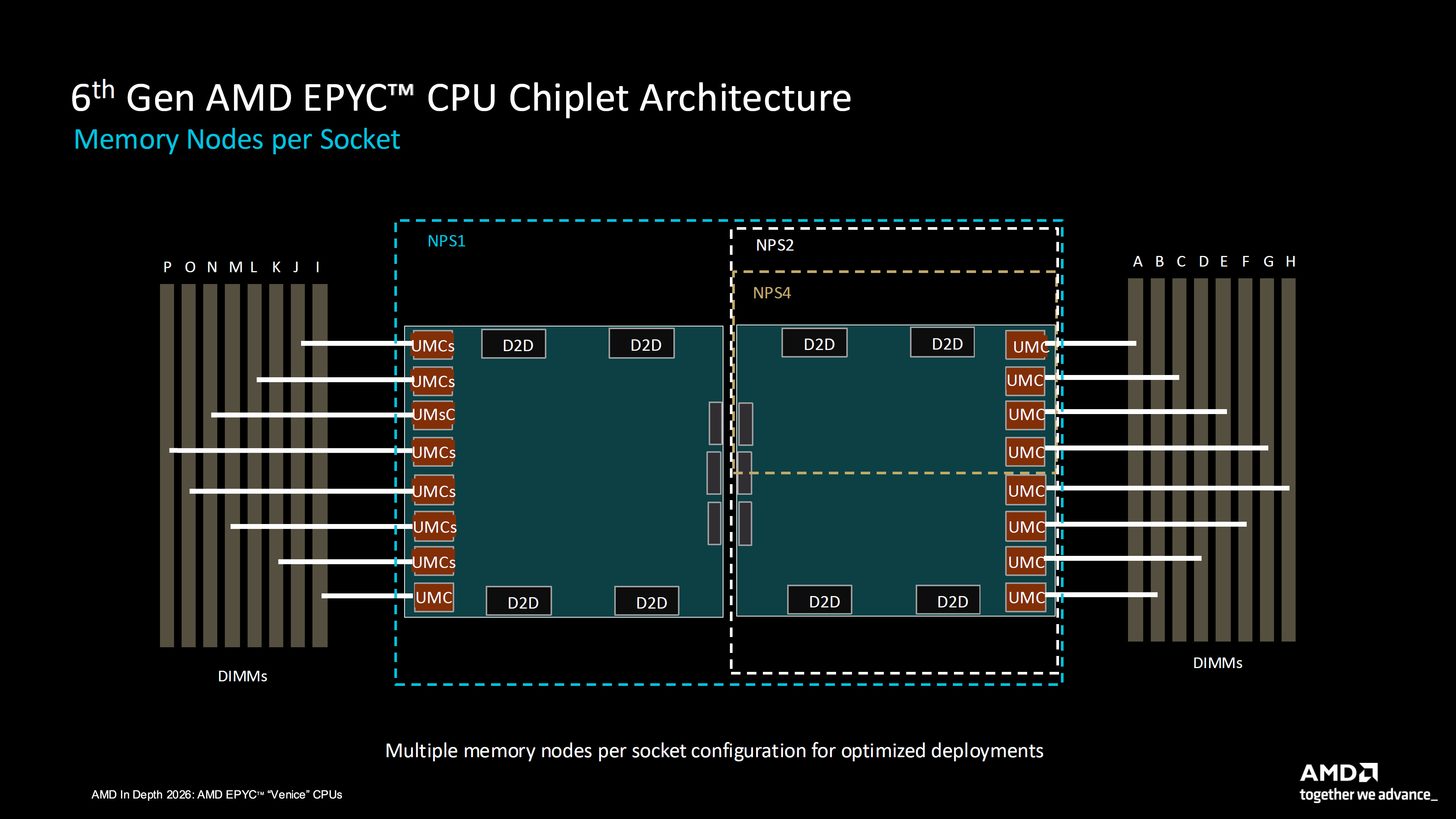
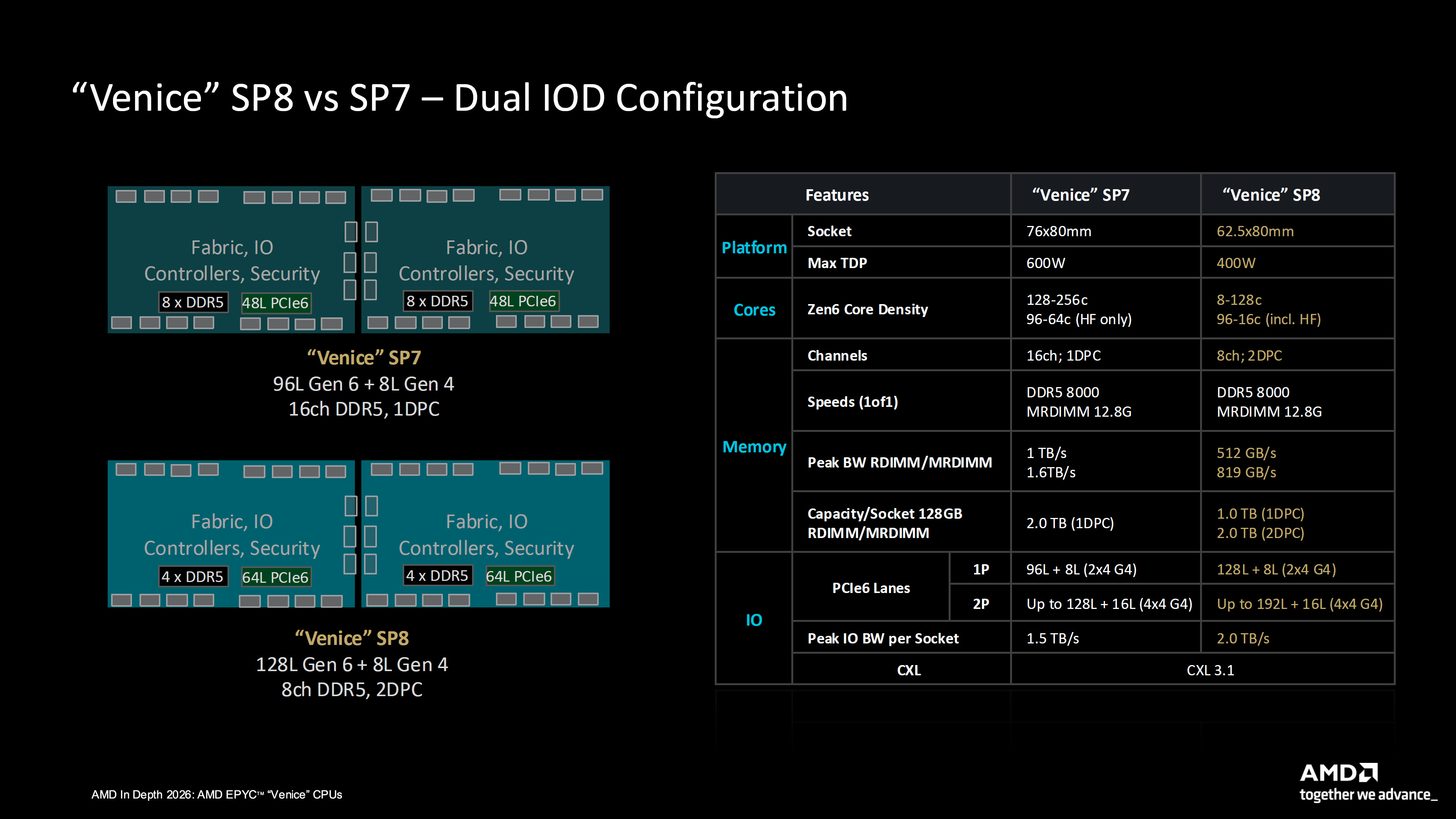
Oprócz części obliczeniowej mamy też ciplety IO wykonane w procesie N3, które w konfiguracji 2P oferują do 128 linii PCIe Gen6 (64 Gbps na linię) i 16 dodatkowych linii PCIe Gen4. Konfiguracje 1P ma z kolei 96 linii Gen6 i 8 dodatkowych linii Gen4. IOD obsługuje warianty PCIe x16, x8, x4 i x2, SDCI (Smart Data Cache Injection) oraz SDXI (Smart Data Accelerator Interface). Każdy IOD obsługuje 8 kanałów pamięci DDR5, które mogą pracować z pamięciami MRDIMM do 12,8 GT/s (1DPC).
                 |
| |
|
|
|
|
|
 |
 |
|
|
|
K O M E N T A R Z E |
 |
| |
|
- AMD nie chwali się (autor: PCCPU | data: 12/11/26 | godz.: 18:47)
Dla ST w Zen6 dostępne są dwa klastry dekodowania 2x4-Wide
- Edit: (autor: PCCPU | data: 12/11/26 | godz.: 19:16)
Zen5 tego nie potrafi!!!
|
|
|
|
|
|
|
|
|
D O D A J K O M E N T A R Z |
|
| |
|
Aby dodawać komentarze, należy się wpierw zarejestrować, ewentualnie jeśli posiadasz już swoje konto, należy się zalogować.
|
|
|
|
|
|
|
|
|
|